教育大数据决策支撑系统 数据处理架构与实战指南
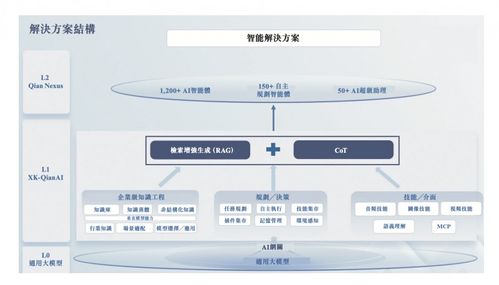
一、引言\n\n在教育信息化2.0和数字化转型的浪潮下,教育大数据决策支撑系统已成为区域教育治理和学校精细化管理的核心工具。这类系统通过对海量教学、管理、行为数据的采集、清洗、分析与可视化,为教育管理者提供科学决策依据。面对多源异构、高并发、隐私敏感的教育数据,如何设计一套稳健、可扩展的数据处理架构,是程序员在开发此类系统时必须攻克的技术难题。本文将围绕教育大数据决策支撑系统的数据处理环节,从数据采集、存储、计算到治理和服务,系统性拆解关键架构与技术选型,并提供可落地的实战建议。\n\n## 二、教育大数据的特点与数据处理挑战\n\n教育大数据区别于其他行业数据的显著特征包括:\n\n1. 多源异构:数据来自教务系统、考试平台、在线学习App、校园卡、物联网设备等,结构化、半结构化和非结构化数据并存。\n2. 按学期/学年周期性爆发:开学、期中、期末、中高考等时间节点数据量激增数十倍。\n3. 强隐私属性:涉及未成年人信息、成绩、行为轨迹,受《个人信息保护法》和教育部《教育数据管理办法》严格约束。\n4. 实时性与离线需求并存:既有校长驾驶舱的准实时看板,也有学年质量分析的T+1离线报表。\n\n这些特点导致传统单机数据库或简单ETL方案难以胜任,需要引入大数据技术栈分层处理。\n\n## 三、数据处理总体架构\n\n针对决策支撑的场景,建议采用“Lambda + Data Lakehouse”混合架构,分为五层:\n\n- 数据源层:业务库(MySQL/PostgreSQL)、日志、消息队列、第三方API。\n- 数据采集层:Flume、Canal、DataX、Kafka Connect 实现全量与增量同步。\n- 数据存储层:HDFS/OSS为原始存储;Hive/ Iceberg/ Hudi为湖仓一体表;ClickHouse/ Doris为OLAP服务。\n- 数据计算层:Spark/Flink 承担批流计算;向量化引擎加速聚合。\n- 数据服务层:统一JDBC/HTTP接口,对接BI、决策模型、API网关。\n\n每一层配合数据质量监控和元数据管理,形成闭环。\n\n## 四、数据采集与预处理的关键技术\n\n### 4.1 采集策略\n\n- 增量捕获:对教务系统采用 Canal 解析 binlog,避免业务库压力;日志端用 Filebeat + Kafka 削峰。\n- 多源合并要统一主键:建议统一学生/教师ID为全系统主键(如学籍号),避免“同人不同码”。\n- 断点续传与幂等:采集过程中用 offsets 或唯一键实现幂等写入,保证故障恢复后不重复不丢失。\n\n### 4.2 数据清洗\n\n教育数据常见脏数据类型包括:重复记录、缺考缺项、科目名称不统一、分制不统一(150分制和100分制混淆)。建议:\n\n- 使用 Spark SQL 编写可配置的清洗规则表,业务方可自助维护。\n- 建立数据标准字典,统一学制、课程代码、考试类型、等级等。\n- 对异常值打标而非直接删除,保留原始“数据痕迹”,满足教育督导审计要求。\n\n## 五、数据存储的分层设计与选型\n\n- 贴源层(ODS):保持与源系统同构,按日期分区,格式推荐 Parquet + Snappy。\n- 明细层(DWD):做清洗、标准化、维度关联,形成宽广表,例如“学生明细宽表-每考一次一行”。\n- 汇总层(DWS):按学校、年级、班级、学科、知识点等维度预聚合。\n- 应用层(ADS):面向“辍学预警”“成绩波动补偿”“教师画像”“区县均衡度”等具体决策场景输出。\n\n后台可选 Iceberg 管理这些分层表,实现 Schema Evolution 和时间旅行,方便政策口径追溯和回头改口径。\n\n## 六、数据处理的核心计算模式\n\n### 6.1 横向统计类\n- 维度枚举有限但交叉维度很大,比如“区县 × 年级 × 学校 × 学科 × 批次”。应使用 Cube 预聚合,相比现场GROUP BY可把报表响应从分钟秒级降到亚秒级。\n\n### 6.2 纵向追踪类\n- 面向学生个体的成长曲线要用窗口函数、滑动聚合、LAG/LEAD 计算增量和排名变动。\n- 长周期追溯涉及几十个学期,建议在数仓按月聚合并存轻量快照,避免全量重刷。\n\n### 6.3 流批结合场景\n- 考试大屏或走班质量直播可能需要秒级更新。可用 Flink 计算开考率、提交率、告警等流氏指标,结果落地Doris并提供明细分页接口拉取。\n\n## 七、数据治理与安全合规\n\n教育相关数据治理四个关键要求:\n\n1. 分级分类:按敏感度分为公开、内部、敏感、核心,标注字段并同步到 Ranger/Sentry。\n2. 最小必要匿名化:决策分析禁止使用真实身份证后八位,学生报告使用脱敏编码替代展示名;任何出口数据都需要审批白名单。\n3. 访问审计:建立完整访问日志——谁、什么时间、导出了哪位范围学生的数据、导出量级多少。-done到人或告警。\n4. 数据到期销毁:原文数据留3个月高热、12个月温存后回流冷湖并人工确认原训练对应时间偏差不允许靠回流遮掩成绩分布判断。这是政策层面关键约束。\n\n## 八、代码与工具示例\n\n以下基于Spark对成绩表的一次完整DWD清洗并进入聚合岗位,可直接落地测试而思路更明确的伪码范式保留主业务环真实流程——开发者一看也能自行以相近路径在同级技术链路开启上线。\n
更新时间:2026-09-21 22:51:56
如若转载,请注明出处:http://www.zhuxiaozhuan.com/product/96.html
PRODUCT
产品列表